职场权益问答助手:我把实习复盘出的结论,做成了自己的版本
一个可以现场演示的 RAG 智能体。用公开法律文本建库, 配上 42 条评测集做全量回归,代码已开源。
- 我的角色
- 独立完成:选题、建库、应用搭建、评测、发布
- 知识库
- 6 类 55 条 QA
- 评测集
- 42 条,全量回归通过
- 技术
- Dify Chatflow · 通义千问 embedding · DeepSeek
一句话摘要
实习那三个月我用 Dify 搭过智能体,但那是公司项目, 细节不能对外讲,也不是我一个人做出来的。
所以我用公开的劳动法文本,把同一套方法独立跑了一遍—— 顺便把实习复盘出的三条改进做进去。它既是一次能力自证, 也是一次对当时那些遗憾的补课。
它长什么样
三条真实问答,分别对应正常回答、复杂计算和边界拒答三种情况。 截图里的知识库版本是 v1.2。
知识库里总共有 55 条问答。我把它们全部做成了一个 可搜索、可按类别筛选的静态站点——不需要后端、不调用模型,因此永久可用。 评测用的 42 条用例也单独做成了一页。
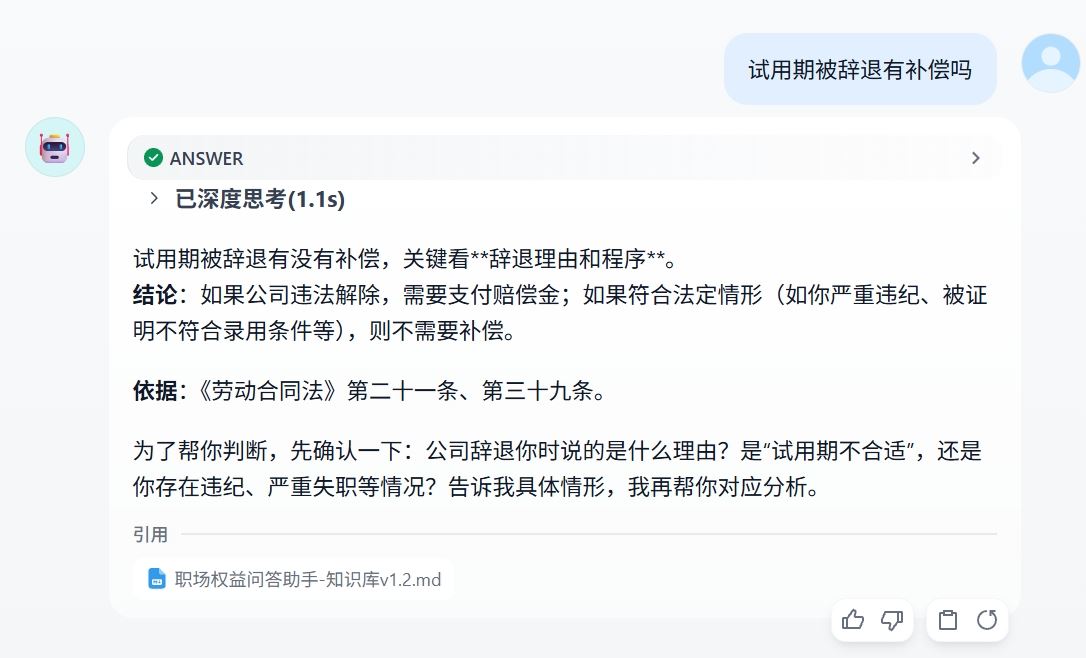
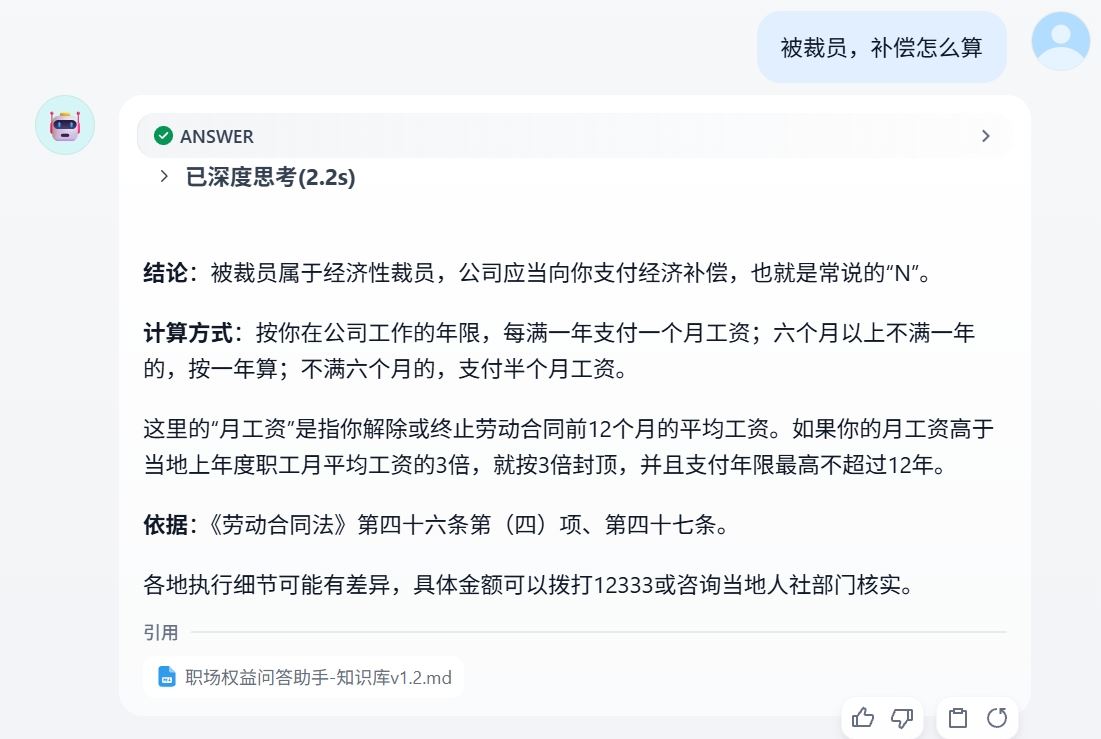
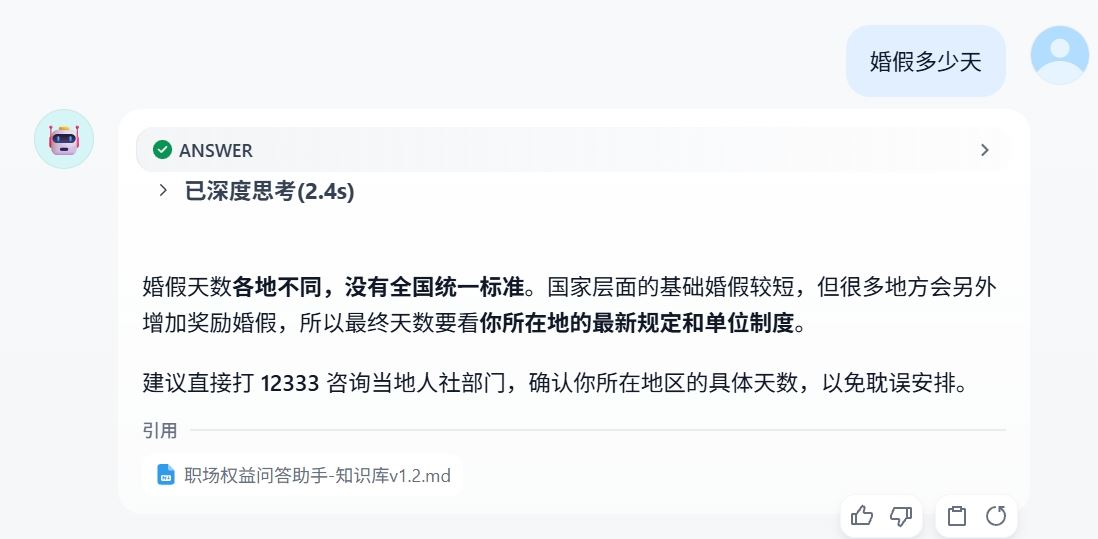
先说我改了什么
这个项目不是把实习项目抄一遍,而是针对实习里暴露的三个问题做了改进:
- 结构化切分控上下文。 按条款和 QA 两个粒度切分,保留法名与条号作为可溯源的锚点。 检索走的是 RAG 的 top-k 片段,而不是把整库塞给模型—— 上下文越脏,多轮对话里累积的干扰越多。
- 高频问题做确定性出口。 沿用实习里「猜你想问」的思路:常见问题直接命中固定答案, 不需要经过模型生成。
- 建回归评测集。 这是实习复盘后我最想补的一块——40 多条用例, 每次改动全量重跑,防止修好一个坏掉两个。
知识库怎么组织
6 个类别共 55 条 QA,覆盖职场里最常见的问题:
| 类别 | 条目 | 为什么单独成类 |
|---|---|---|
| 试用期 | 11 | 时长、工资下限、辞退补偿都是高频争议点 |
| 工资与加班 | 8 | 加班费倍数、工资条构成,口径容易记混 |
| 社保公积金 | 12 | 条目最多,覆盖《社会保险法》与公积金管理条例 |
| 休假 | 8 | 年假、婚假、产假、陪产假规则差异大 |
| 离职与补偿 | 11 | N / N+1 / 2N 的适用场景是最容易出错的地方 |
| 裁员 | 5 | 与离职补偿相邻但适用条件不同,单独拆开避免混淆 |
除了按法条切分,我还加了一层口语别名标签—— 因为用户不会用法律术语提问。说「被开除」「裁员」的人, 要找的其实是离职补偿那一类。
法源用的是 7 部已逐条核对的官方文本, 其中《住房公积金管理条例》采用 2026-08-10 第三次修订的现行版本—— 法律条文会随年份修订,用旧版建库比不知道更危险。 每条回答都要求能追溯到具体法条。
评测集是「什么叫做对了」的定义
42 条评测用例,每条四个字段:问题 | 期望回答要点 | 来源法条 | 状态。 单轮和多轮各跑一遍。
我给自己定的标准不是「看起来能答」,而是 每次改动之后,我都能知道它变好了还是变坏了。 这两件事听起来接近,实际上差很远——前者靠感觉,后者要有基线。
一个真实的 bad case,以及我怎么定位它
裁员补偿的问题,模型回答「没有查到依据」——它误判了库里没有相关内容。
排查顺序沉淀下来是三步:先看资源与服务层(额度、服务状态), 再看检索有没有召回,最后才归因到生成侧。
结论是:既不是知识库内容写错了,也不是提示词有问题, 而是底层 embedding 服务额度耗尽,导致检索根本拿不到结果。 换成自备模型 key、重建知识库之后,同一个问题复测通过。
修复并重新构建知识库后重跑:42/42 全量通过。
这个 case 教给我的是:检索命中不等于答对。 检索没召回、召回但模型输出错、以及知识库本身版本不对, 是三个不同层次的故障,混在一起排查只会来回打转。
成本、延迟与质量的取舍
AI 产品有一个普通产品没有的成本结构:每一次生成都要花钱、都要等, 而且上下文越长,两样都越贵。所以我在这个项目里给自己划了一条很简单的分界线。
| 问题类型 | 走哪条路 | 为什么这么选 |
|---|---|---|
| 高频、答案固定 | FAQ 直达,不调用模型 | token 成本归零,响应从「等待生成」变成即时 |
| 长尾、但有法条可依 | 检索 top-k 片段后交给模型 | 用检索把上下文收窄:既省钱,也减少无关片段的干扰 |
| 超出知识库范围 | 不生成,引导到官方渠道 | 一次错误回答的代价,远高于一次诚实的「我不知道」 |
还有一项容易被忽略的成本:依赖的服务本身。 前面那个裁员 bad case 的根因就是 embedding 服务配额耗尽—— 这类失败不会报错,只会让回答悄悄变差,而你可能几天都发现不了。 所以我现在会把模型和 embedding 的依赖关系写进发布检查项, 而不是假设它一直可用。
验收标准
我给自己设的现场演示标准是 3 分钟能跑通这四件事:
- 口语化提问 → 给出带法条依据的回答
- 高频问题点击直达,不经过生成
- 每个回答都可溯源到具体法条
- 超出范围的问题不乱编,引导到 12333 或当地人社部门
最后一条是我特意留的。一个问答产品在不确定的时候怎么说 「我不知道」,比它在确定的时候答得多漂亮更能说明问题。
如果重来一次
最值得记的一条是:那个 bad case 的根因指向 embedding 服务的配额耗尽。 这提醒我 AI 产品有一个普通产品没有的失败源—— 依赖的外部服务会在你不知情的时候发生变化。
现在我会把模型和 embedding 的依赖关系显式记下来,作为发布前的检查项。 另外这个项目目前只覆盖 6 个类别,工伤和劳动争议救济还没做, 地方政策差异也没有分地区处理——这些是明确的待办,不是遗漏。
说明
这个项目用的是公开的法律文本和公开的官方渠道信息, 定位是帮助普通人理解常见问题,不构成法律意见。