AI 产品
从需求分层到评测体系:参与搭过真正上线的智能体,也独立复刻了一版并补上回归评测。
不是所有问题都值得走大模型
先按「高频刚需 > 流程复杂 > 补充疑问」给问题排序划定范围, 再让高频问题走确定性出口,模型只处理长尾。
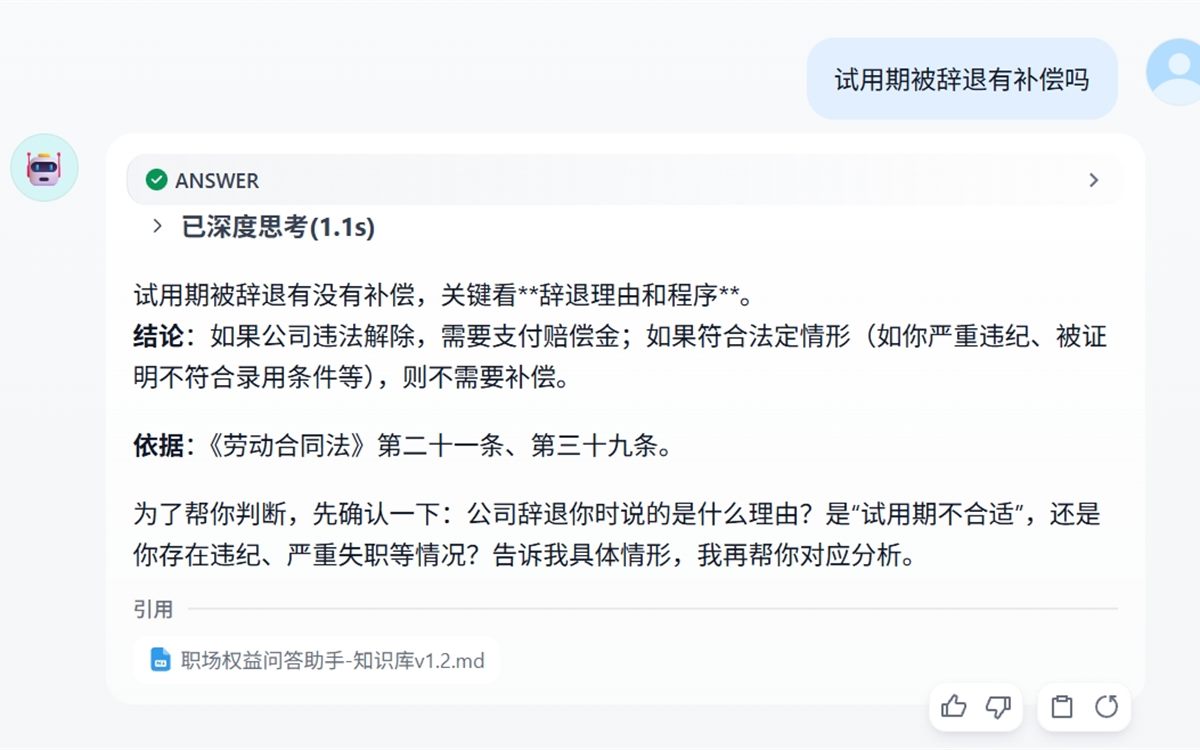
把复盘出的结论,做成自己的版本
独立搭一套劳动法 RAG 问答,补上实习时最想补的回归评测集: 每次改动全量重跑,42 条用例全部通过。
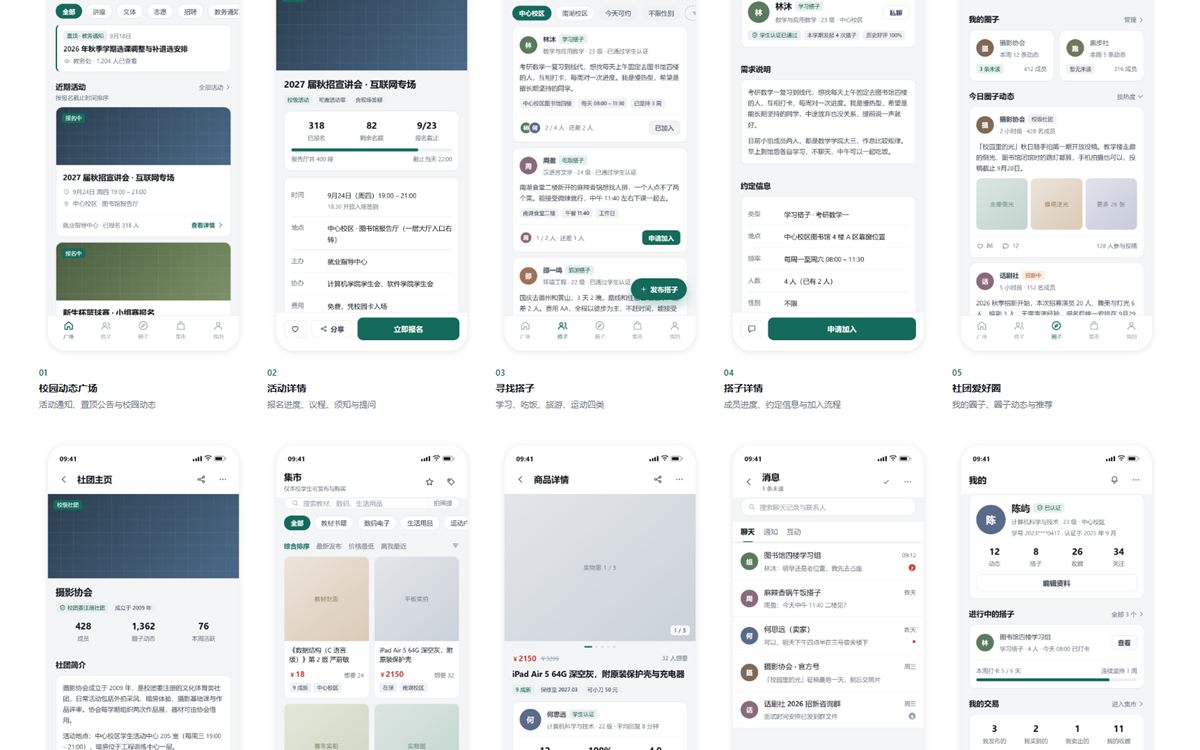
校汇圈:把校园里的四件事,收进一个 App
产品基本功的补充:从竞品分析、信息架构到可交互原型与指标体系。 竞品分析得出的结论是——真正的对手不是同类 App,而是微信群。
AIGC 生成
一条 ComfyUI 素材流水线 + 三条科普短片。前者用架构保证产品一致性,后者全部由代码绘制、没有一帧素材。
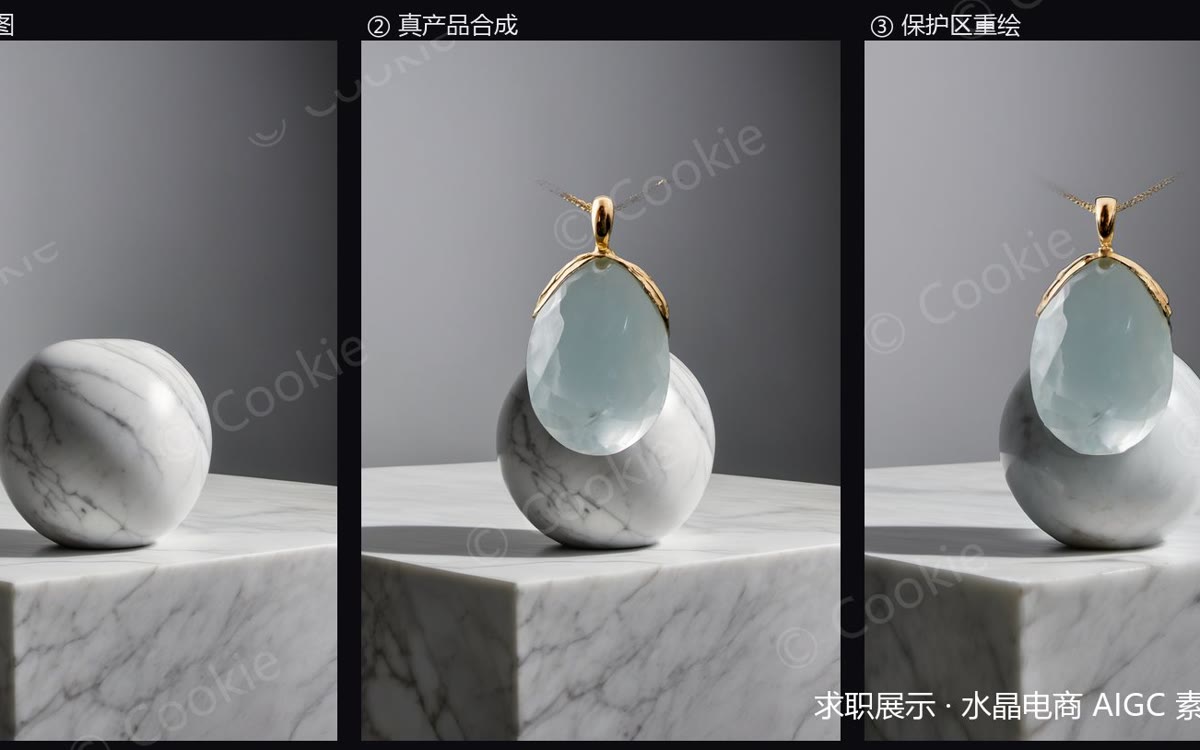
用架构保证一致性,而不是靠提示词祈祷
用 latent noise mask 把产品像素排除在扩散之外,只重绘背景与边缘光影; 再建 SSIM / ΔE / 亮度漂移量化质检。
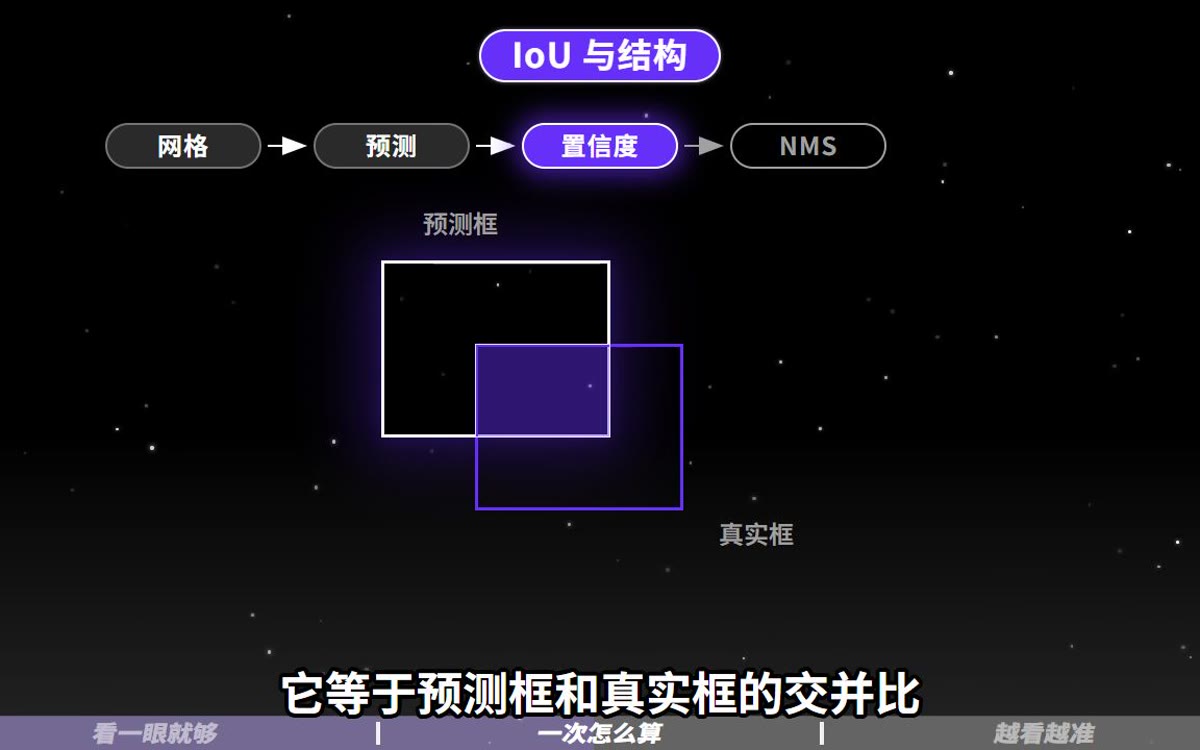
先跑通一条现成的流水线
《YOLO 是怎么识别物体的》。把一条只在 macOS / Linux 上能跑的开源链路修到 Windows 可用, 再用事实核对抓出自己写的两处数据错误。
把上一期提的四条改进,全部落地
《机会成本》。同一套本地流水线,这一期没换路线,换的是执行: 钩子开场、10 种转场、逐句字幕、6 色配色与 13 个火柴人。
零成本做出一条 2′29″ 的知识短视频
《马太效应》。放弃生成式视频、改走代码渲染, 把过程固化成一条可重跑的流水线。成片可以直接在页面上看。
数据分析
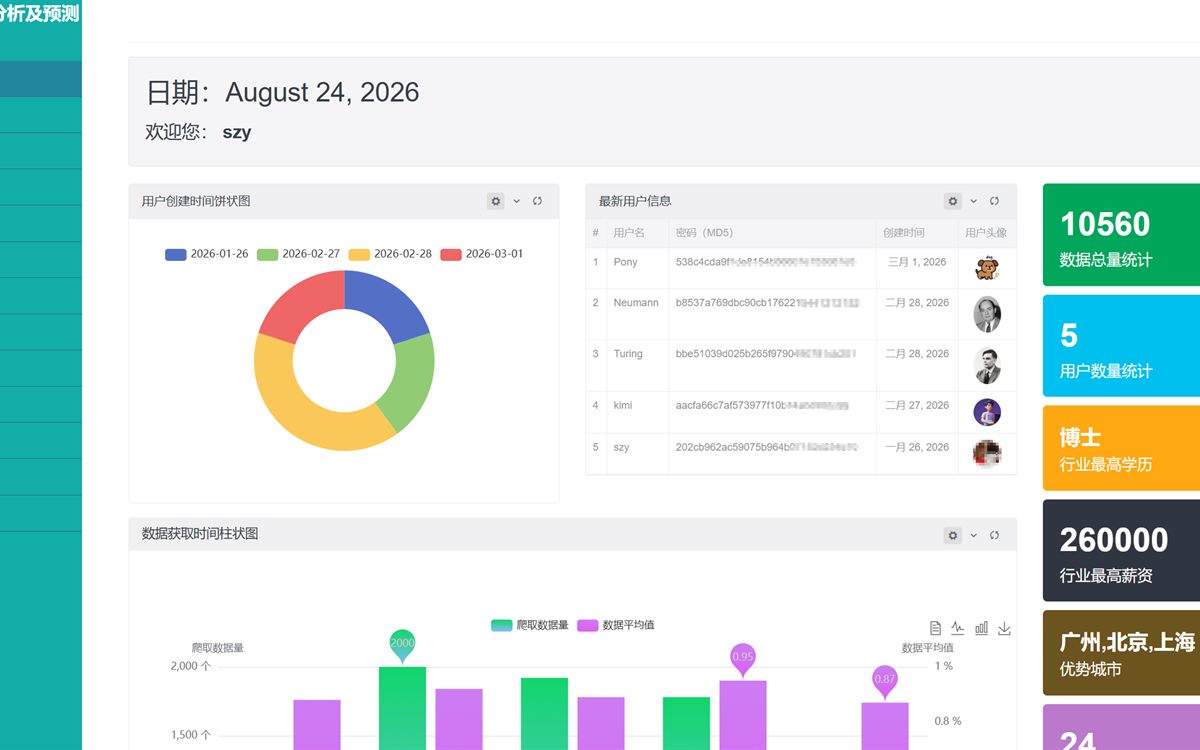
爬虫 → Spark 清洗 → 六维可视化 → 随机森林预测,一个完整跑通的数据系统;再加两段数据实习。
相关经历
-
2025.07 – 2025.09
万兴科技 · 数据采集实习生
长沙
Python 爬虫采集公开数据,统一格式与命名、筛选、打包成可用数据集; 对目标数据做初步标注与质检,至多三检提炼合格数据。 短期需求一周内交付,长期需求按排期分次交付——单批样本数据集至少 5000 个对象。
-
2024.07 – 2024.09
长沙赛洛体育 · 店长助理
长沙
用 Pandas 处理引流数据优化拉新策略;用 SQL + Python 定位低余额会员、 生成个性化推荐名单;用 Matplotlib / Seaborn 搭数据看板支持管理层决策。
三个方向,同一套做法
下面这三条在每一类项目里都会出现,也是我认为自己最稳的部分。
先定约束,再选路线
做智能体先定「什么叫做对了」,做视频先定画幅、时长和合规要求。 约束写下来之后方案空间自然就窄了——生成式视频很酷, 但「不可控、每次抽卡」这一条就足以把它排除掉。
只有真依据能上屏
AI 产品里,每个回答都要能追溯到知识库里的法条; 视频里,只有有出处的数字能上屏,其余全靠四则运算推出来。 没有出处的比例,连画成柱子都不行。
验收不靠感觉
拼图自检、响度实测、逐条链接扫描、结构配平。 「看起来差不多」和「验证过」是两件事—— 我踩过的坑几乎都是在只靠感觉的时候踩的。
关于我
我是施祖粤(Zoey),广州理工学院数据科学与大数据技术专业 2026 届毕业生。求职方向:AI 产品 / AIGC 内容生产 / 数据分析。
我的路径是从数据走到产品的:先做 Python 爬虫、Spark 数据处理和 2 万+ 条数据分析, 再进到 AI 产品——Dify 智能体、RAG 知识库、评测与幻觉核查; 最近又把 AIGC 内容生产的完整流程自己跑了一遍。 数据背景带来的好处很具体:我能直接读懂模型输出、评测结果和数据报表,不用等人翻译。