薪资分析预测系统:拆掉后端,做成一张纯静态的网站
从爬虫采集、Spark 清洗分析,到六维可视化、薪资预测和 AI 岗位匹配。 为了让招聘方点开链接就能看,我把它从 Django + MySQL 改造成了 333 个不需要任何服务的静态页面。
- 我的角色
- 独立完成:采集 · 分析 · 后端 · 前端 · 部署
- 数据规模
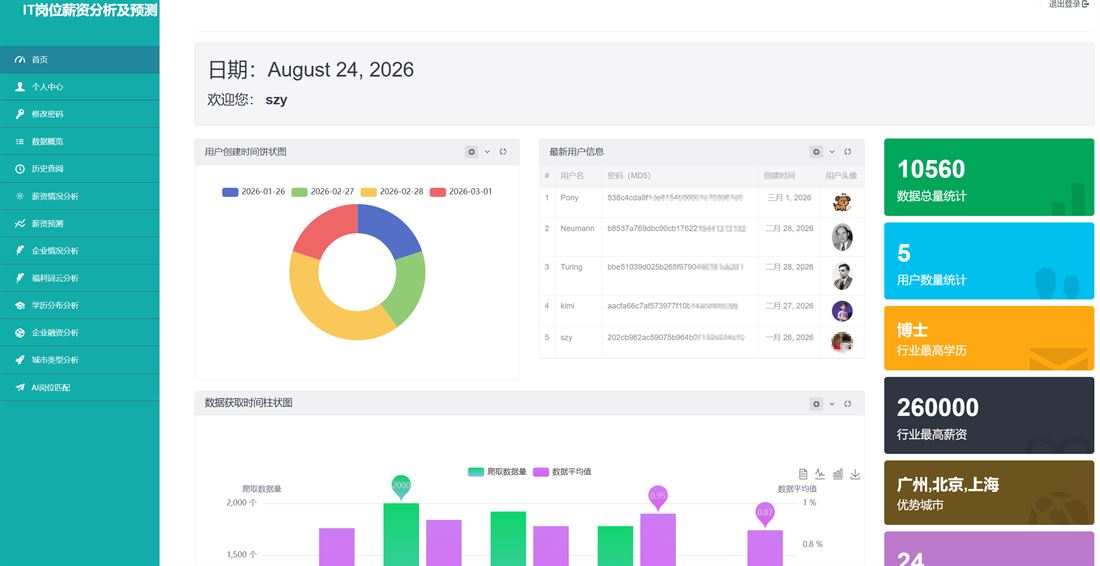
- 采集 2 万+ 条,上线快照保留 10560 条岗位全量
- 技术栈
- Python 爬虫 · Spark / Scala · Django · MySQL · ECharts
- 线上地址
- itjobs.pages.dev
一句话摘要
IT 岗位的薪资信息散落在招聘平台上,求职者想知道「我这个城市、这个学历、 这个经验年限,大概值多少钱」,只能一页页翻岗位自己猜。
这个系统把这件事做完了:爬取岗位数据 → Spark 分布式清洗与统计 → 六个维度的交互式可视化 → 随机森林薪资预测 → 接入 DeepSeek 的简历与岗位匹配。
六个分析维度,加两个「不只是看图」的模块
| 模块 | 它回答的问题 |
|---|---|
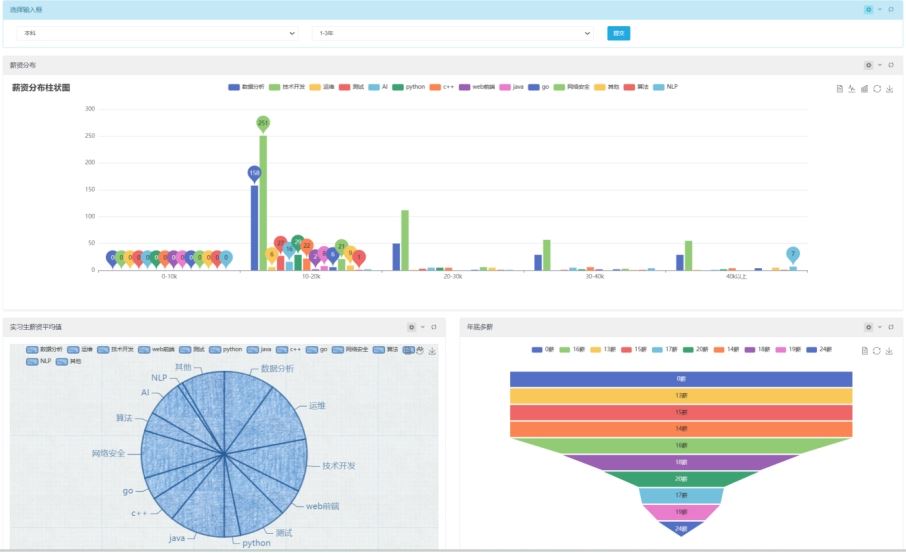
| 薪资情况 | 不同学历 × 经验年限下,薪资区间怎么变 |
| 企业情况 | 不同类型的公司都在招什么岗、给多少钱 |
| 学历分布 | 这个岗位到底卡不卡学历 |
| 企业融资 | 融资阶段的公司薪资是否更有竞争力 |
| 城市类型 | 一线 / 新一线 / 二线的岗位需求差异 |
| 福利词云 | JD 里被反复提到的福利关键词是什么 |
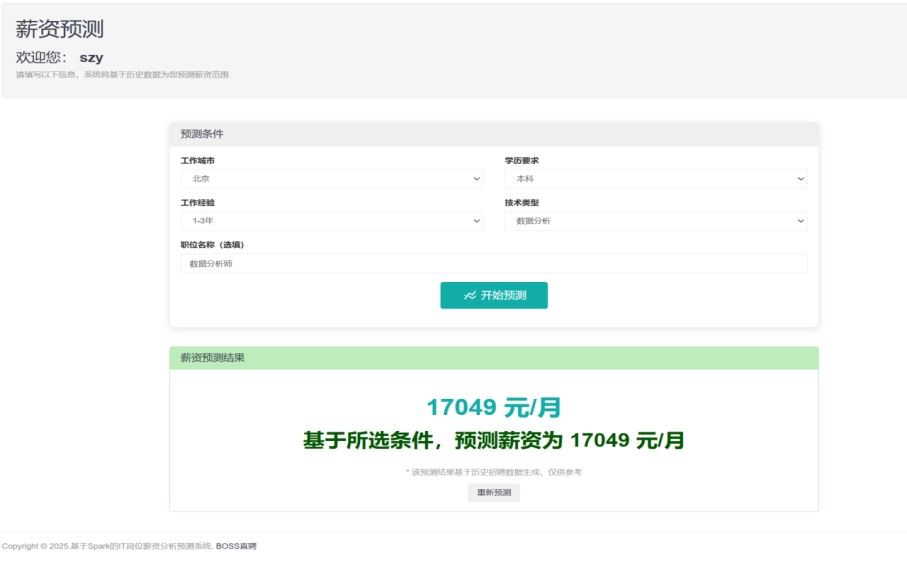
| 薪资预测 | 输入城市、学历、经验、公司类型,直接给出预测薪资 |
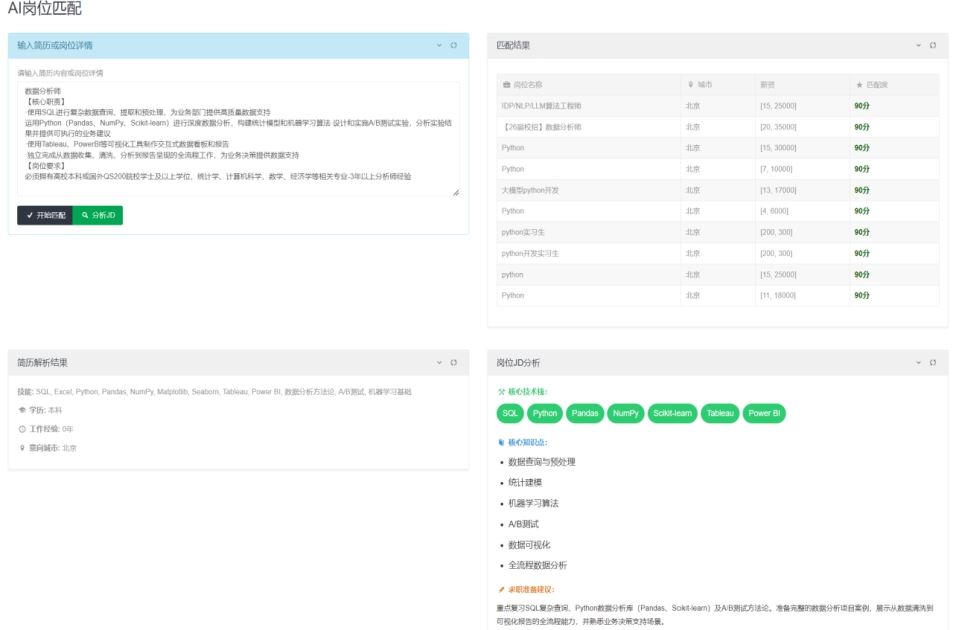
| AI 岗位匹配 | 上传简历,由大模型解析并与岗位做匹配打分和 JD 分析 |
前六个是「看得懂数据」,后两个才是「能帮你做决定」—— 这也是我在这个项目里最在意的部分。
关键决策:把后端拆掉
原系统是 Django + MySQL,要跑起来得有服务器和数据库。 这在答辩时没问题,但它带来一个很实际的后果: 我把链接发给面试官,对方点开看到的是一张打不开的页面。
所以我做了一个决定:把整个系统在本地离线渲染成静态页面, 不接数据库、不做后端,发布到 Cloudflare Pages。 代价是放弃一部分动态能力,换来的是「任何人点开链接就能看」。
最难的一块:让薪资预测在纯静态环境里活下来
静态化本身不难,难的是那些依赖后端的交互。最先保不住的就是薪资预测—— 它原本是提交表单、后端调用随机森林模型、返回结果。 没有后端,这个功能按理说应该直接砍掉。
我换了个思路:模型只有四个输入项——城市、学历、经验、公司类型。 它们的组合数是有限的,一共 6720 种。 与其在线调模型,不如把这 6720 种组合的预测结果提前算好写进页面, 用户点「开始预测」时直接在浏览器里查表出结果。
这本质上是一次成本、延迟与质量的取舍: 预计算的代价是产物变大、也无法覆盖新的输入组合; 换来的是零推理成本、零等待,以及在任意静态托管上都能跑起来。 对「发给别人看一眼」这个场景来说,这个交换明显划算。
同样处理的还有筛选和分页:原本是 GET 参数,现在全部预生成为页面之间的跳转。 最终产物是 333 个 HTML 页面,数据概览里 10560 条岗位一条不少, 分页、筛选、预测都能真点。
脱敏:要公开,先得干净
这份数据来自真实招聘平台,里面带着真实的人。所以我先做了脱敏, 再考虑发布:
- 招聘者姓名与职务(数万行)统一替换为「招聘者」
- 用户表里的真实用户名(原本是手机号之类)改成「用户 8」「用户 11」
- 用户密码(MD5)与真实头像全部清除,不进入产物
- 手机号字段根本不写进数据库,因此不会出现在任何页面上
做完这些之后,我又对最终 609 个文件做了一轮正则扫描—— 手机号、32 位哈希、API Key、内网 IP、邮箱、姓名模式,确认没有命中才发布。
这件事让我意识到一个容易被忽略的点:作品集的公开范围,是一个需要主动决定的产品决策, 不是做完顺手一传的事。带真实个人信息的演示数据,传上去的那一刻就收不回来了。
静态版的边界,我也写在页面上
拆掉后端之后,有几处功能确实用不了。我没有把它们藏起来或者做成假按钮:
- AI 岗位匹配不可用——它需要调用 DeepSeek 的后端接口。 点击时页面会明确提示「静态演示版:AI 功能需要 DeepSeek 后端接口,此处未启用」。
- 登录 / 注册 / 修改密码保留页面但只做展示,提交时说明需要后端数据库。
- 历史记录保留页面,写库动作不生效。
我的判断是:一个产品的边界和它的能力同样重要。 与其让面试官点进去发现是假的,不如直接写清楚哪里是演示、哪里是真的。
截图
下面是静态版实际运行的样子,可以直接去 itjobs.pages.dev 点。
如果重来一次
踩过的坑里有两个值得说,因为它们都不是技术问题,而是流程问题。
第一个:我一开始手工改了十几个已生成的页面,结果重跑构建时全部被覆盖, 页面上出现一批死链。教训很直接——对产物做的手工修改,一定要先回到生成它的脚本里, 否则下一次构建就是一次事故。
第二个:打包时用了 PowerShell 的 Compress-Archive,
它写出的条目名是用反斜杠分隔的,Cloudflare 会把整个路径当成文件名,
结果 static/ 目录下全部 404。改用 Python 的 zipfile 手动指定正斜杠之后就正常了。
这件事让我明白,部署链路上的细节和功能本身一样会影响成败,
而且它们的失败方式往往是「看起来部署成功了,实际全是坏的」。
至于 AI 岗位匹配,如果重做,我会把它和薪资预测放在同等优先级: 前者是「大模型能做什么」的展示,后者是「不用大模型也能做得更好」的展示, 两者放在一起才是完整的产品判断。
说明
数据来自公开招聘平台,仅供学习研究使用。已对招聘者信息、用户账号、 联系方式等完成脱敏,产物中不含任何真实个人信息。 本项目为毕业设计,AI 匹配模块在静态演示版中未启用后端接口。