零成本做出一条 2′29″ 的知识短视频
为抖音 #vibe知识大赏 活动做的《马太效应 / 相对年龄效应》。 画面用代码渲染、配音用系统自带 TTS、配乐在剪映配—— 全程零 API 调用、零积分、零花费。
- 我的角色
- 独立完成:选题 · 分镜 · 渲染 · 配音 · 混音 · 自检
- 成片
- 2′29″(149 s)· 60 屏 · 1080×1920 @30fps · 4470 帧
- 技术栈
- hypit(HTML/CSS/JS 动画渲染)· 自研黑金图元库 · System.Speech · ffmpeg
- 成本
- ¥0(对比上一条用生成式视频的片子 ¥12)
一句话摘要
我把「做一条能投活动的知识短片」当成一次产品交付来做: 先定约束、再选路线,然后把过程固化成一条可重跑的流水线, 最后用拼图和响度实测来验收——而不是渲完就交。
成片
2′29″,竖屏 9:16。建议点开声音看。
视频本体 5.6 MB,为网页做了重新编码。抖音投稿版使用剪映配乐,此处为同一版内容的网页适配版本。
这是第一期。第二期把本页提的改进全做了一遍
本页末尾列的「四个改进方向」,在第二期《机会成本》里逐条落地了: 钩子问题开场、10 种转场、逐句字幕 + 6 色配色 + 13 个火柴人、配乐交给剪映。 看第二期 →
第一步不是写脚本,是定约束
活动给了硬约束,这些先框住了方案空间:
- 竖屏 9:16,知识科普类内容
- 时长目标「实际控制到两分半最好」
- 标题必须以活动名开头,必须带指定话题标签
- 发布时必须标注「内容由 AI 生成」——这是硬性要求
- 不允许引流营销
关键决策:放弃生成式视频,改走代码渲染
最直接的路线是用生成式视频工具做画面,但那意味着要烧积分、 而且效果不可控——每一条片子都是一次抽卡,改一个镜头的成本还很高。
所以我换了个问法:不问「生成式 AI 能画出什么」,而问 「代码能画出什么」。用 hypit 把 HTML/CSS/JS 动画渲染成视频, 画面完全可控、可复现、可重跑,成本为零。
代价是画面风格被限制在线条和几何图形里。但对「讲清一个机制」这类内容来说, 这个限制反而合适——看图的人不需要照片级真实感,他需要一眼看懂对应关系。
分镜表先行:秒数和文案先锁死,再写代码
60 屏的分镜表先定下来:每一屏的屏号、秒数、文案、图形、转场。 确认之后才开始写渲染代码。
原因很实际:改一个字,全片秒数就要重排。 在表上改是一分钟的事,等代码写完再改是一小时的返工。
| 章节 | 时间 | 讲什么 |
|---|---|---|
| 开场 | 0–19 s | 抛现象,把三个关键数字依次砸出来 |
| 加拿大冰球 | 19–54 s | 1 月生 ∶ 11 月生 = 5.5 倍 |
| 季度分布 | 54–94 s | Q1 占 40%,Q4 只占 10% → 4.0 倍 |
| 欧洲足球 | 94–120 s | 25 个赛季、14,173 名球员,Q1 30.4% ∶ Q4 20.1% |
| 反转与收束 | 120–149 s | 倍数在下降,但机制仍在——把「注意力」当通用机制讲 |
平均 2.5 秒一屏,节奏偏快,是照着短视频的注意力曲线排的。
只有真数字能上屏
这条片子全片只出现 7 个数字—— 5.5、4.0、1.5、30.4%、20.1%、14,173、25—— 每一个都有出处,一个编的都没有。
除了「不用假数据」,还有三条更细的纪律:
- 单位不同就换标签。 三个数分别是「倍」和「%」,计数器标签统一写「最高 ∶ 最低」, 不写「倍数」——否则第三个数字在单位上就是错的。
- 反转结论必须带限定词。 讲「占比在下降」时,屏上必须同时出现「在某些统计里」, 否则就是把单一研究的结论当成普遍规律。
- 不点名平台算法。 讲机制就讲「注意力」这种通用机制,不写「某个平台的推荐算法怎么运作」。
这几条看起来是内容问题,其实是产品问题—— 一条知识视频如果经不起评论区追问,它的传播寿命就到此为止。
语速是算出来的,不是猜的
配音用 Windows 自带的 System.Speech。第一版按默认语速合成, 13 段总长 174.5 秒——而 149 秒的片子只有 146.2 秒的可用窗口,塞不进去。
把语速参数调到最快,得到 147.7 秒,再用逐段变速压进各自的窗口。 变速上限设在 1.2 倍——超过这个比例人声就开始像机器人。
沉淀成一个可以直接用的经验值
5.2 汉字/秒。下次写解说词时按这个估字数: 一个 10 秒的窗口最多写约 48 个字,再留 3% 余量。 这样在写稿阶段就能知道塞不塞得下,不用等合成了才发现要砍内容。
踩过的坑
坑一:成片响度只有 −28.6 LUFS,人声几乎听不见
混音完之后听感正常,但实测响度只有 −28.6 LUFS(目标约 −14)。
根因很反直觉:同一路音频被消费了两次—— 一次拿去做侧链压缩的触发信号,一次进混音总线。 ffmpeg 遇到这种图会把它劈成两半,结果整整衰减了约 14 dB。
修法是显式加一个 asplit,让两路各用各的。
这个 bug 不报错、不崩溃,只是让结果「看起来很成功但实际是坏的」——
这也是为什么我把响度实测固定成了交付前的必做项。
坑二:自己覆盖了自己的成片
一条拷贝命令把已经混好音的成片(7.37 MB)覆盖成了无声版本(3.79 MB), 而那一版已经交出去了。
教训不是「小心一点」,而是把校验变成流程: 拷贝前先核对文件大小,混音完成后立刻校验时长与响度,通过了才叫交付。
坑三:画面和自己的台词打架
有一屏的台词在说「还没有出现枢纽的网络」,而图上的网络却画了一个带脉冲的大枢纽—— 画面在反驳自己的解说。
这类问题只有把台词和图逐屏对照才会发现。 我为此给图元加了一个扁平模式:节点尺寸统一、连线降低透明度、不画枢纽脉冲。
验收不靠眼睛
把 60 屏拼成两张总览图,一眼就能看出哪屏空、哪屏挤。
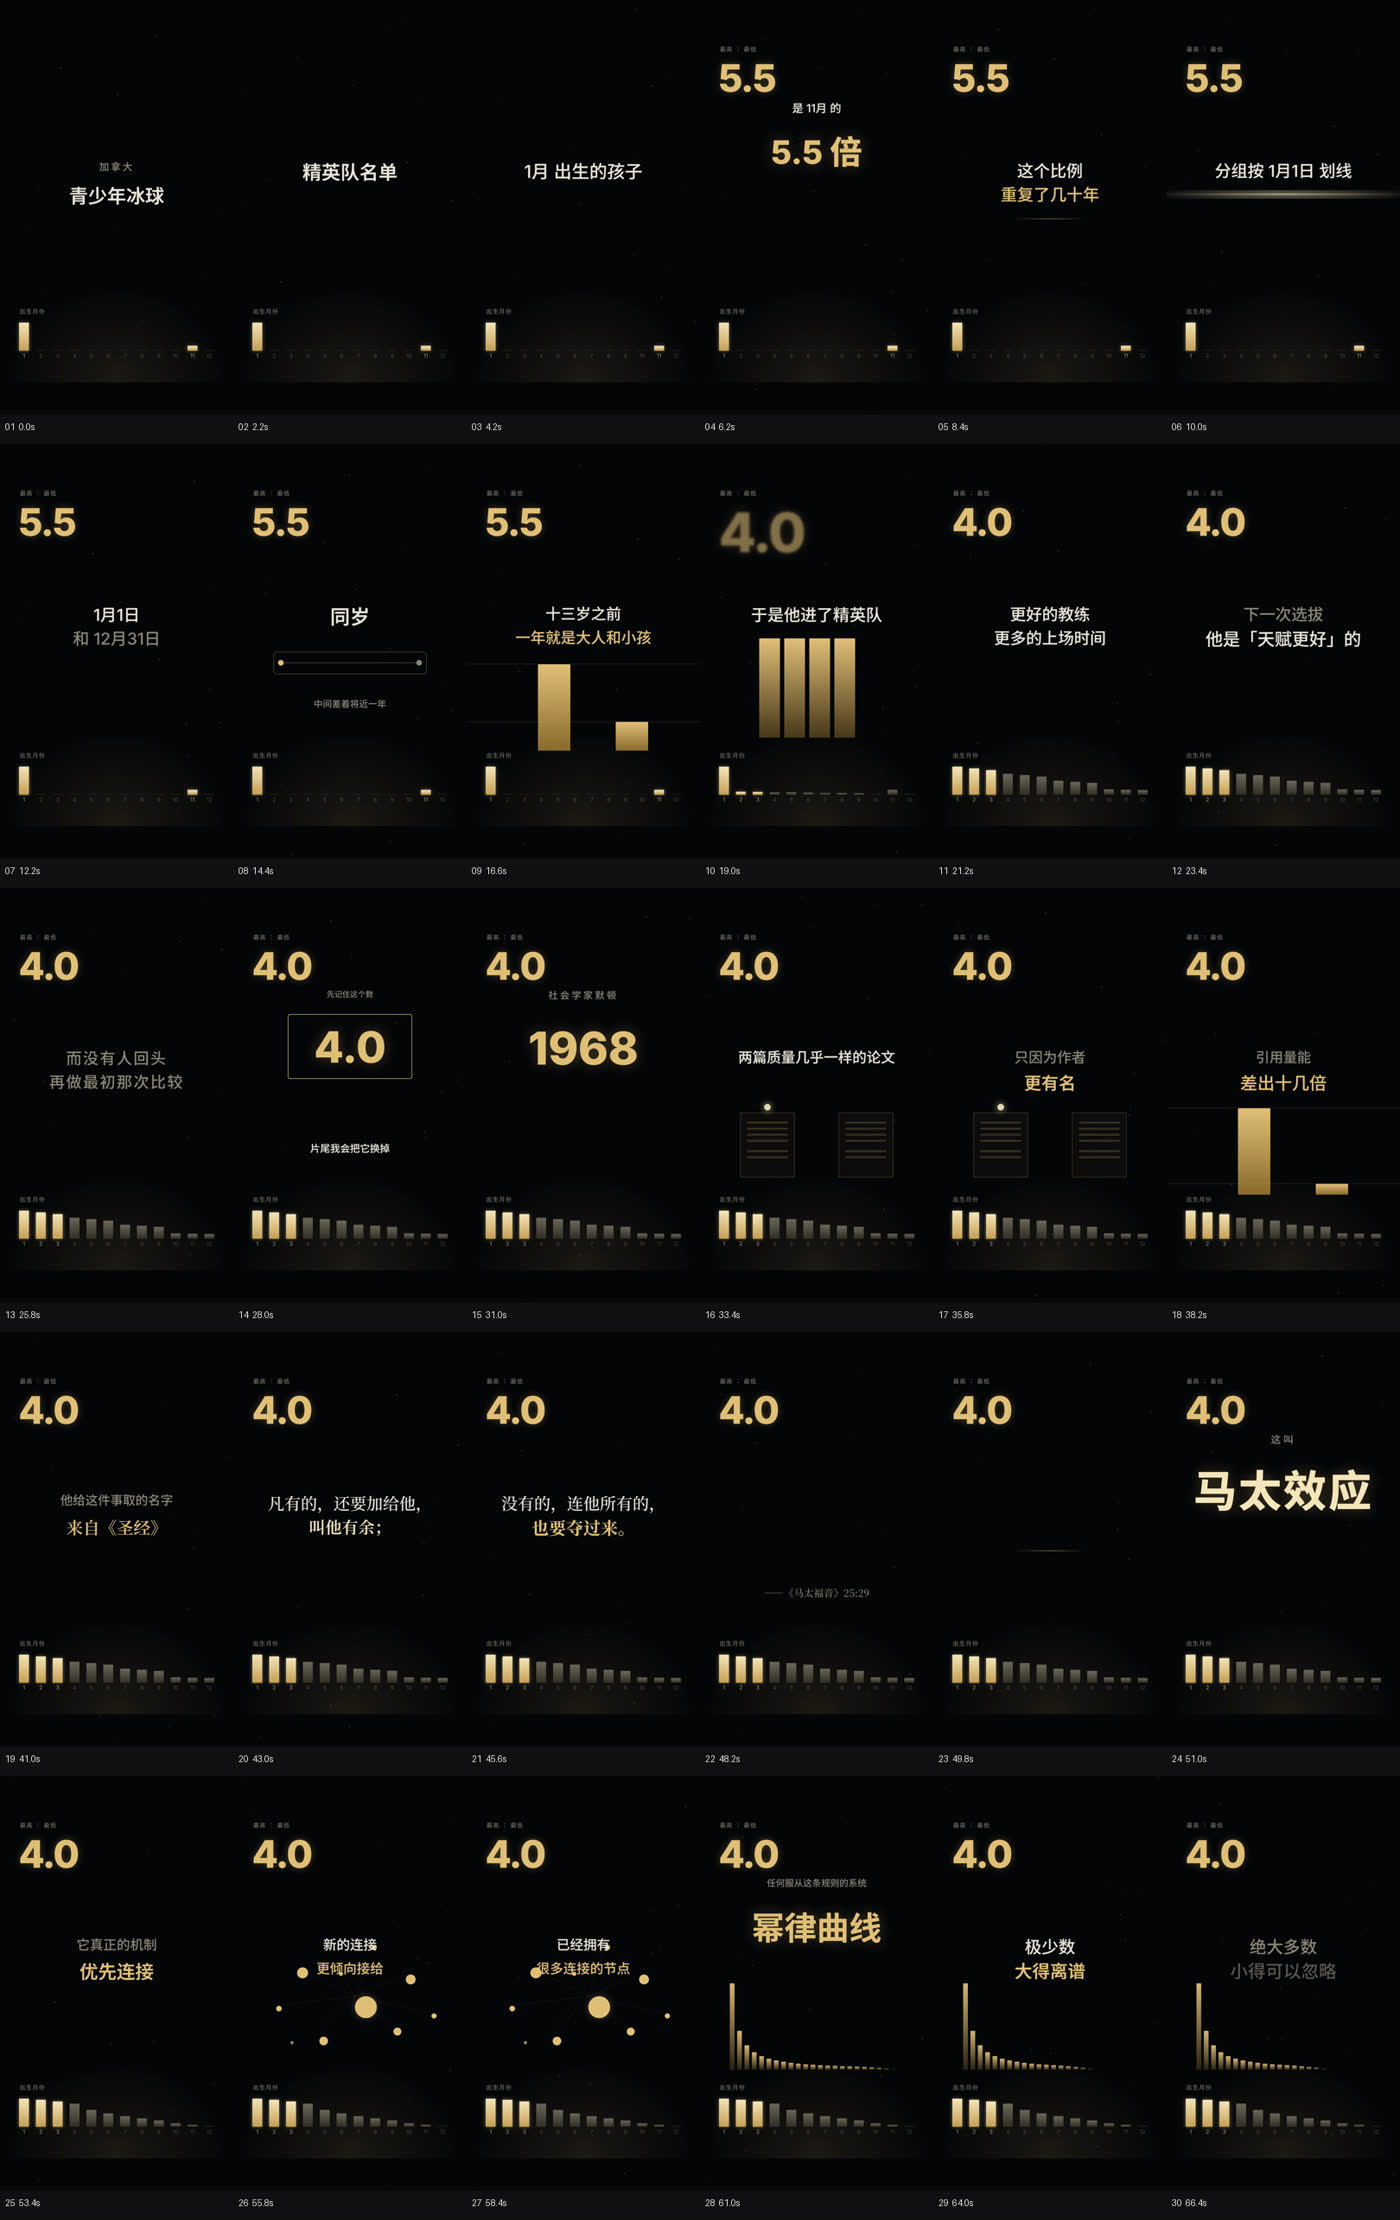
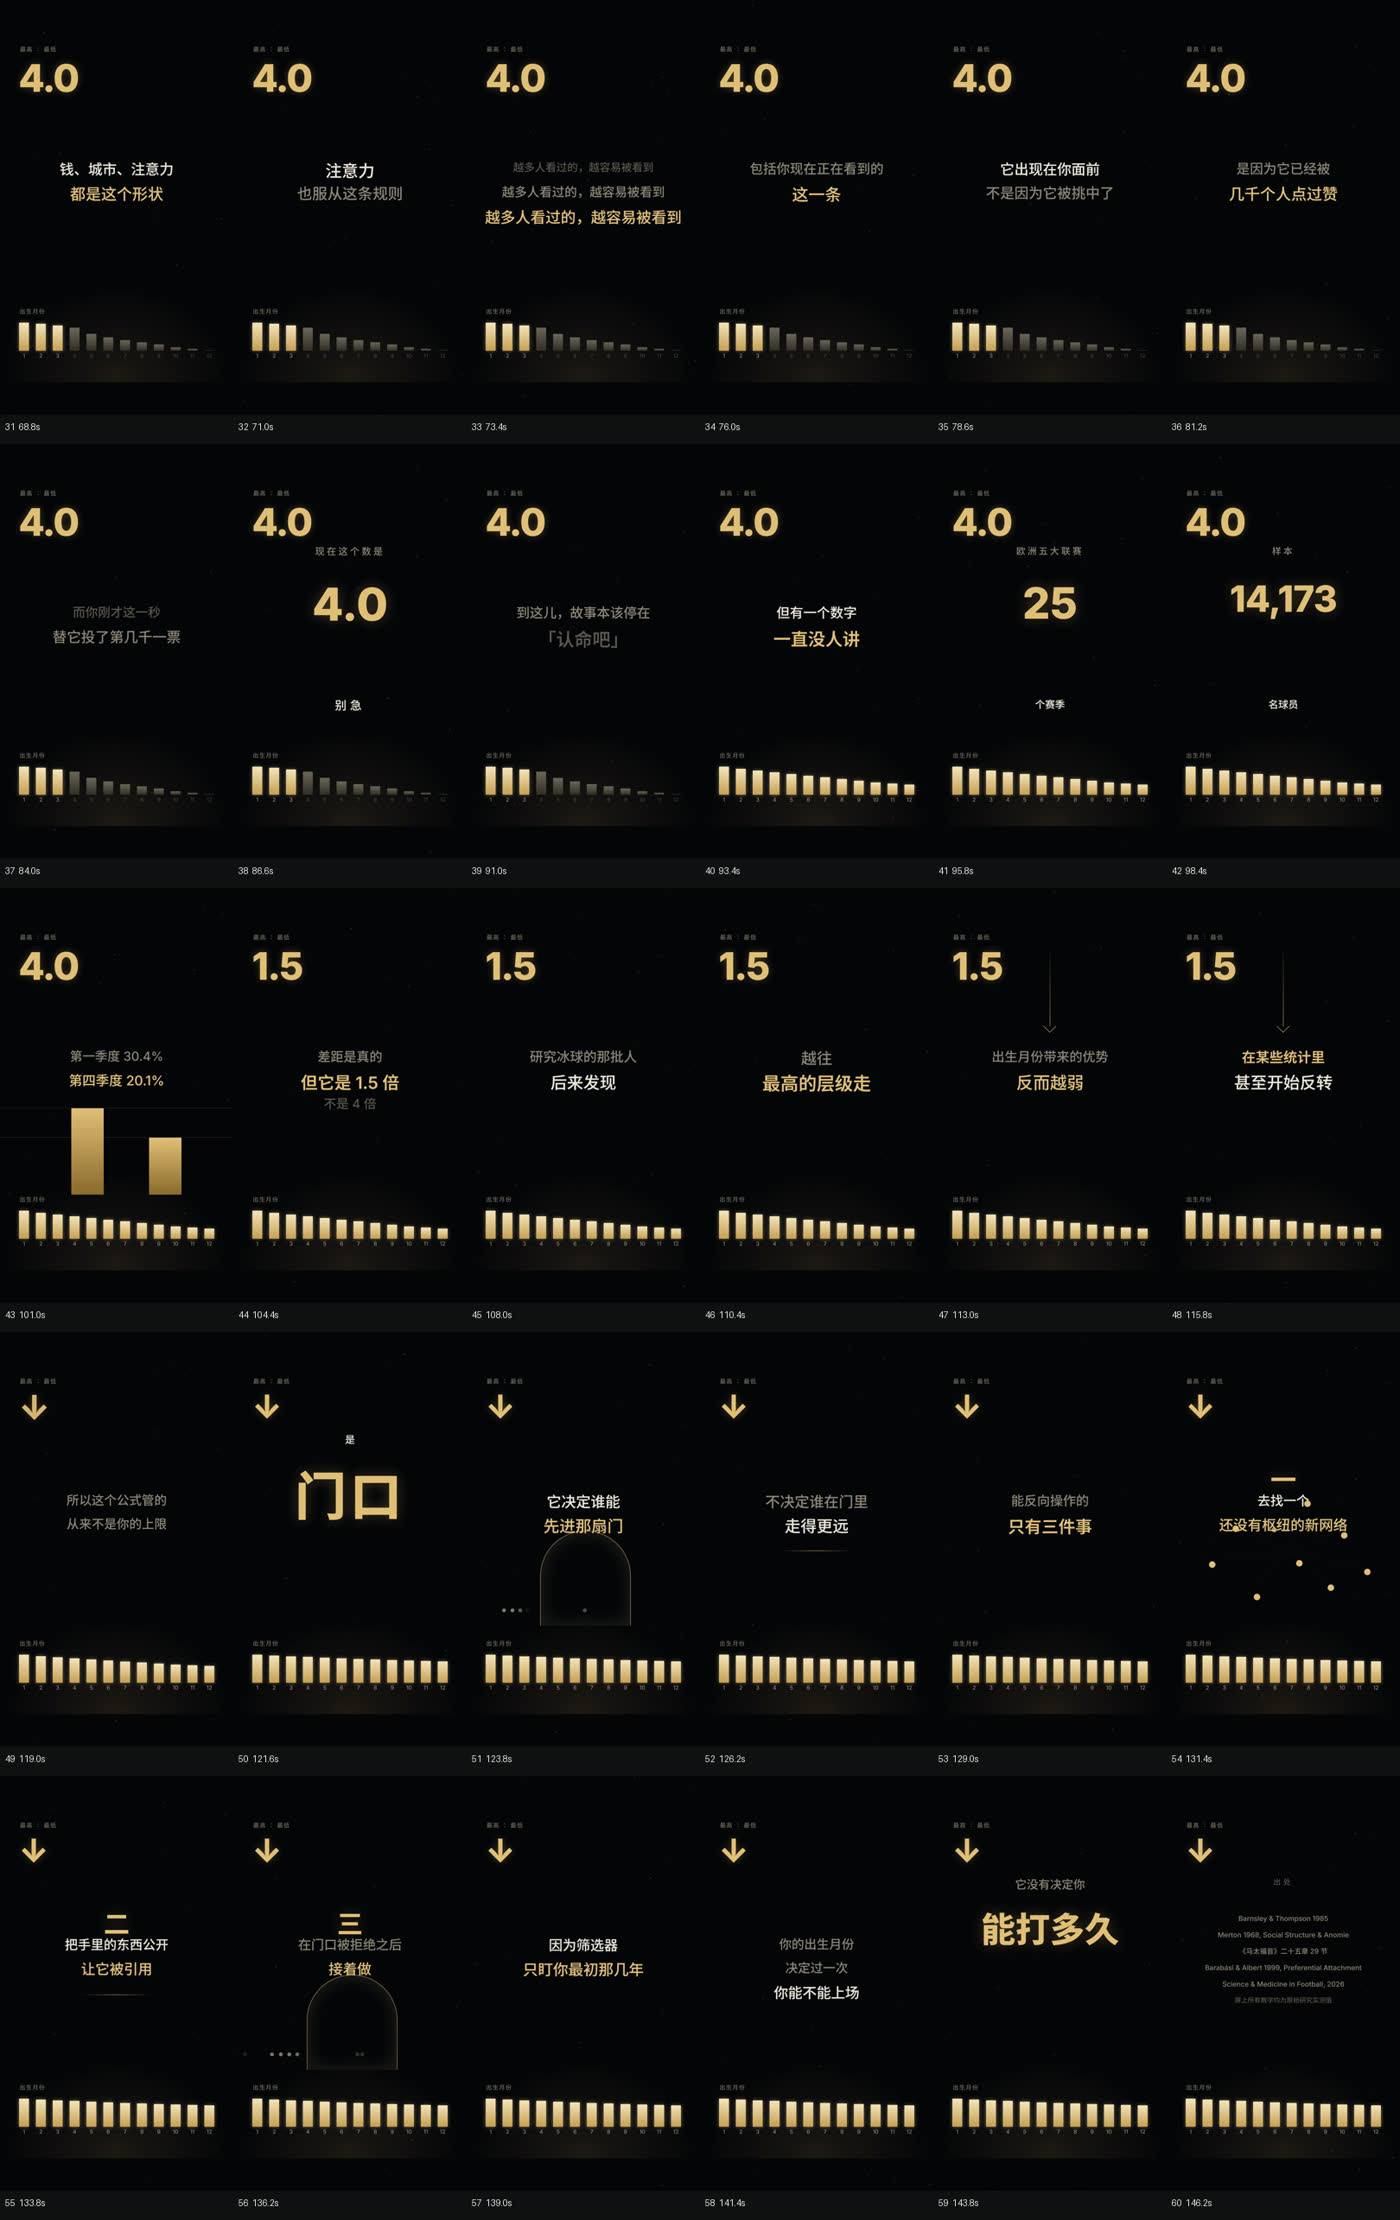
三步自检:拼图扫一遍全片节奏 → 可疑的屏单独看全分辨率 → 逐 5 秒量 RMS 和响度。
这次一共修掉 5 处画面缺陷——图形压住字幕、箭头顶到文字、 某屏元素看起来像孤儿、画面与台词矛盾、以及一处图元标记写坏导致整片失效。 全部是靠这套流程看出来的,没有一处是靠"感觉差不多了"。
合规是不能碰的底线
这次活动对 AI 生成内容有明确的标注要求。这类要求不是「尽量做到」, 而是发布的前提条件——做不到就不该发。
| 要求 | 我怎么落地的 |
|---|---|
| 标题以活动名开头 | 标题模板固定,写在交付清单里 |
| 带指定话题标签 | 同上,作为发布前的检查项 |
| 标注「内容由 AI 生成」 | 硬性要求,发布时必须勾选 |
| 禁止引流营销 | 全片不出现引导关注、不留私域入口 |
把合规当成产品需求而不是「发布时的注意事项」,是我在这件事上最主要的收获。 一条片子做得再好,触了规则就等于零。
如果重来一次
渲完看成片之后,我自己列了四条必须改进的地方:
- 开头要有钩子。 这次开场直接讲现象,前 3 秒留不住人。 正确的做法是先抛一个「观众自己遇到过、但从没想通」的问题—— 比如「为什么冷清的餐馆越来越没人,排队的餐馆越来越火爆?」。 但钩子必须是真问题,片子里得给出解释,否则评论区会翻车。
- 画面和转场要更丰富。 60 屏基本是「一屏一张静态图 + 淡入淡出」,屏与屏之间硬切,看久了累。 应该加位移、缩放、擦除,以及图形的跨屏延续(上一屏的线条延伸成下一屏的坐标轴)。
- 加字幕、加颜色、加人物。 抖音观众大量静音刷,没有字幕等于放弃一半人。 配色也应该在黑金之外补 2–3 个强调色,用来区分正反对比和不同主体。
- 配乐交给剪映。 我先用脚本合成了一版配乐,结论是「不难听但也不加分」, 最后还是人工配的。五分钟挑一首比写两百行合成代码强。
这次最值钱的一条认知
成片的黑金视觉很「高级」——黑底、金线稿、超粗黑体, 拿去做产品发布会都不违和。但结果是: 画面大多是图表加字幕,刺激不到经常刷视频的人的多巴胺。
黑金很高级,可刷短视频的人要的是热闹和情绪。 数据扎实是底线,钩子、字幕、人物、转场才是留存率。 这两件事我这一版只做到了前者。
这次做对了什么
- 零成本路线走通了。 证明了「不用积分、不调 API 也能出成片」——这是最大的收获。
- 分镜表先行。 秒数和文案锁死之后再写代码,返工量很小,三次整片渲染就是全部。
- 只有真数字上屏。 全片 7 个数字都有出处,经得起评论区质疑。
- 把流程写成了可复用的东西。 工程、分镜表、配音脚本、混音命令、踩坑对照表都留了下来, 下一条片子可以直接重跑。
说明
画面与配音由本地代码和系统 TTS 生成,配乐在剪映人工完成。 全片数据取自公开研究,只使用有出处的真实数字,不包含任何推测值。