《YOLO 是怎么识别物体的》:先跑通一条现成的流水线
2′21″ 横屏科普片,30 个镜头全部由代码绘制、没有一帧素材。 这条走的是另一条技术路线——用开源的视频生成技能加云端 TTS, 成本约 ¥12。
- 我的角色
- 独立完成:主题 · 调研 · 解说词 · 分镜 · 镜头 · 质检
- 成片
- 2′21″(141.4 s)· 30 镜头 · 1280×720 @30fps · 4240 帧
- 技术栈
- Remotion + React / TypeScript · edge-tts(云希)· ffmpeg
- 成本
- 约 ¥12(模型 token),与开工前估算吻合
一句话摘要
主题是「YOLO 是怎么识别物体的」——从一个 7×7 网格怎么变成 98 个候选框讲起。 但这条片子真正的价值不在内容本身,而在两件事: 我把一条在 Windows 上跑不起来的技术链路修通了, 以及我用一套事实核对流程抓出了自己写的两处数据错误。
成片
2′21″,横屏 16:9。建议点开声音看。
视频本体 8.7 MB,为网页做了重新编码。
先跑通,再谈优化
这条是三支片子里最早做的一条。当时的思路很直接: 先用现成的东西做出一条完整的片子,看看一条合格的知识视频到底要经过多少道工序。
做完之后我才有了判断依据,去试第二条和第三条完全本地的路线。两条路线的取舍很清楚:
| a2e 路线(这一条) | 本地路线(后两条) | |
|---|---|---|
| 画面 | Remotion + React 代码动画 | hypit(HTML / CSS / JS) |
| 配音 | edge-tts 云希(云端服务) | Windows 系统 TTS(本地) |
| 成本 | 约 ¥12(模型 token) | ¥0 |
| 画幅 | 1280×720 横屏 | 1080×1920 竖屏 |
| 优势 | 现成的分镜流程与视觉规范 | 零成本、完全可控、可无限重跑 |
后两条用的是哪条路线、为什么,写在 《马太效应》和 《机会成本》里。
技能在 Windows 上跑不起来,所以我把它修好了
这条片子用的是一条开源的技术链路。它在设计上默认跑在 macOS / Linux 上, 直接拿到 Windows 上基本每一步都会断。我花了这次约 80% 的时间在环境适配上, 最后把修复提交回了技能本体,共 3 个提交,并补了一份中英双语的 Windows 安装指南。
其中四个修复值得单独记下来,因为它们都是那种「不报错但结果不对」的问题:
| 问题 | 后果 |
|---|---|
| 语音库新版默认返回句级边界而不是词级边界 | 字幕块的起点会静默退化成按字数线性插值——看起来能跑,字幕却是错位的 |
| Windows 下 Python 默认按 GBK 写文件 | 字幕与时间轴文件写成 GBK,渲染端按 UTF-8 读——中文字幕全变乱码 |
| 语音库的流式请求没有超时 | 实测卡死 7 分钟以上不返回,必须自己包超时与重试 |
| 多层柔光的透明度不是相加而是 1−(1−a₁)(1−a₂) | 按相加估算会把亮度算低,导致主角自己的光被判定为异常色块(见下一节) |
这三条里,最值钱的是第二条
GBK / UTF-8 那一条如果只看「有没有报错」,是完全正常的—— 文件写出来了、渲染也跑完了,只有人眼看片子才会发现字幕是乱码。
这也是我后来在所有脚本里死守一条规矩的来源: 文本读写一律显式指定 UTF-8,不依赖系统默认。
事实核对抓出了我自己写的两处错误
调研阶段所有事实都带 URL 出处,抓取的原件也留了档。 即便如此,成稿后我仍然让另一个流程逐句核对解说词与画面上的每个数字, 结果抓出两处问题:
| 问题 | 性质 | 处理 |
|---|---|---|
| 解说词写「YOLO11 的参数比上一代少了 22%」 | 出处原文是「YOLO11m 比 YOLOv8m 参数少 22%」—— 我把一个具体型号的对比,放大成了整个系列 | 改词,画面小字也改成完整口径 |
| 分镜原本要写「IoU 阈值 0.7」 | 调研文档和原始论文里都没有这个数字—— 属于我自己顺口编的 | 改成只写「阈值」,不带数值 |
这一条值得对所有做内容的人说
第一处错误的教训是:数字有出处,不等于这句话有出处。 出处说的是 A 比 B 少 22%,我写成「这一代比上一代少 22%」—— 数字没变,句子变成了另一个主张。
所以核对不能只核「这个数字对不对」,要按 「主语 + 限定词 + 数字」三层一起核。 这一点在 AI 产品里同样成立:模型输出的每句话,都要能追溯到知识库里的依据, 而不是「里面有正确答案的词」就算对了。
一个常量,踩了全片 30 个镜头
这条片子的视觉规范是「黑底 + 白线稿 + 紫色重点」。检测脚本会把画面里的 「紫色碎片」当作异常来统计,用来抓视觉噪声。
结果第一版跑出来,30 个镜头里有 6 个被判为异常。查下去发现: 主角高亮的柔光是用两层叠加的阴影做的, 按相加估算亮度是偏低的,实际合成后的亮度超过了判据阈值—— 主角自己的光,被脚本数成了「紫色碎片」。
修法是把柔光常量重新算一遍。这件事本身很小,但它是典型的 「一个共享常量会影响所有下游产物」—— 改动的是一行数值,影响的是 30 个镜头的质检结论。
质检:从 17 个低分改到 11 个,然后停手
渲染完之后跑量化质检:逐镜头量主体尺度、空场帧数、柔光、紫色碎片、静止帧数。 三个版本的结果:
| 版本 | 高 | 中 | 低 |
|---|---|---|---|
| v1 | 0 | 3 | 17 |
| v2 | 0 | 2 | 10 |
| v3(交付) | 0 | 2 | 11 |
注意 v2 的「低」是 10,v3 反而回到 11。 因为我把某个元素改小去消掉「碎屑」,却让另一个镜头的问题变多了—— 这些量化指标不是单调下降的,每改一处都要复测。
剩下的问题,我明确写了「不修」
交付时我列了一张「已知保留项」表,逐条写明哪个镜头、什么现象、 以及为什么故意不修。举几条:
- 背景碎屑偏多(两处):这两镜要表达的就是「每格一个哨兵」的点阵, 任何小点都会被判成碎屑。试过改小半径,反而让静止帧变多、观感更弱—— 属有意偏离,不是失误。
- 静止帧偏多(四处):这几镜都是「一次成形后保持」的类型 (网格、折线、参数对比),设计上就是要停住让观众看清。加推近可以消掉标记, 但会削弱「停住」的意图。
- 紫色碎片偏多(五处):都是紫色本身就是内容的地方。 要压到阈值以下只能减少紫色用量,会违背「紫色 = 当前重点」的整套视觉语义。
- 一处是判据口径差:一个 110px 的大数字,脚本按图形档的 170px 判,规范里本来就允许大字小一些。
结论是:与其反复重渲去追一个数字,不如把「为什么不修」写清楚。 该停手时要停手——继续优化下去的收益已经小于它带来的返工风险了。
30 个镜头总览
每个镜头抽一帧,一张图扫完全片节奏。
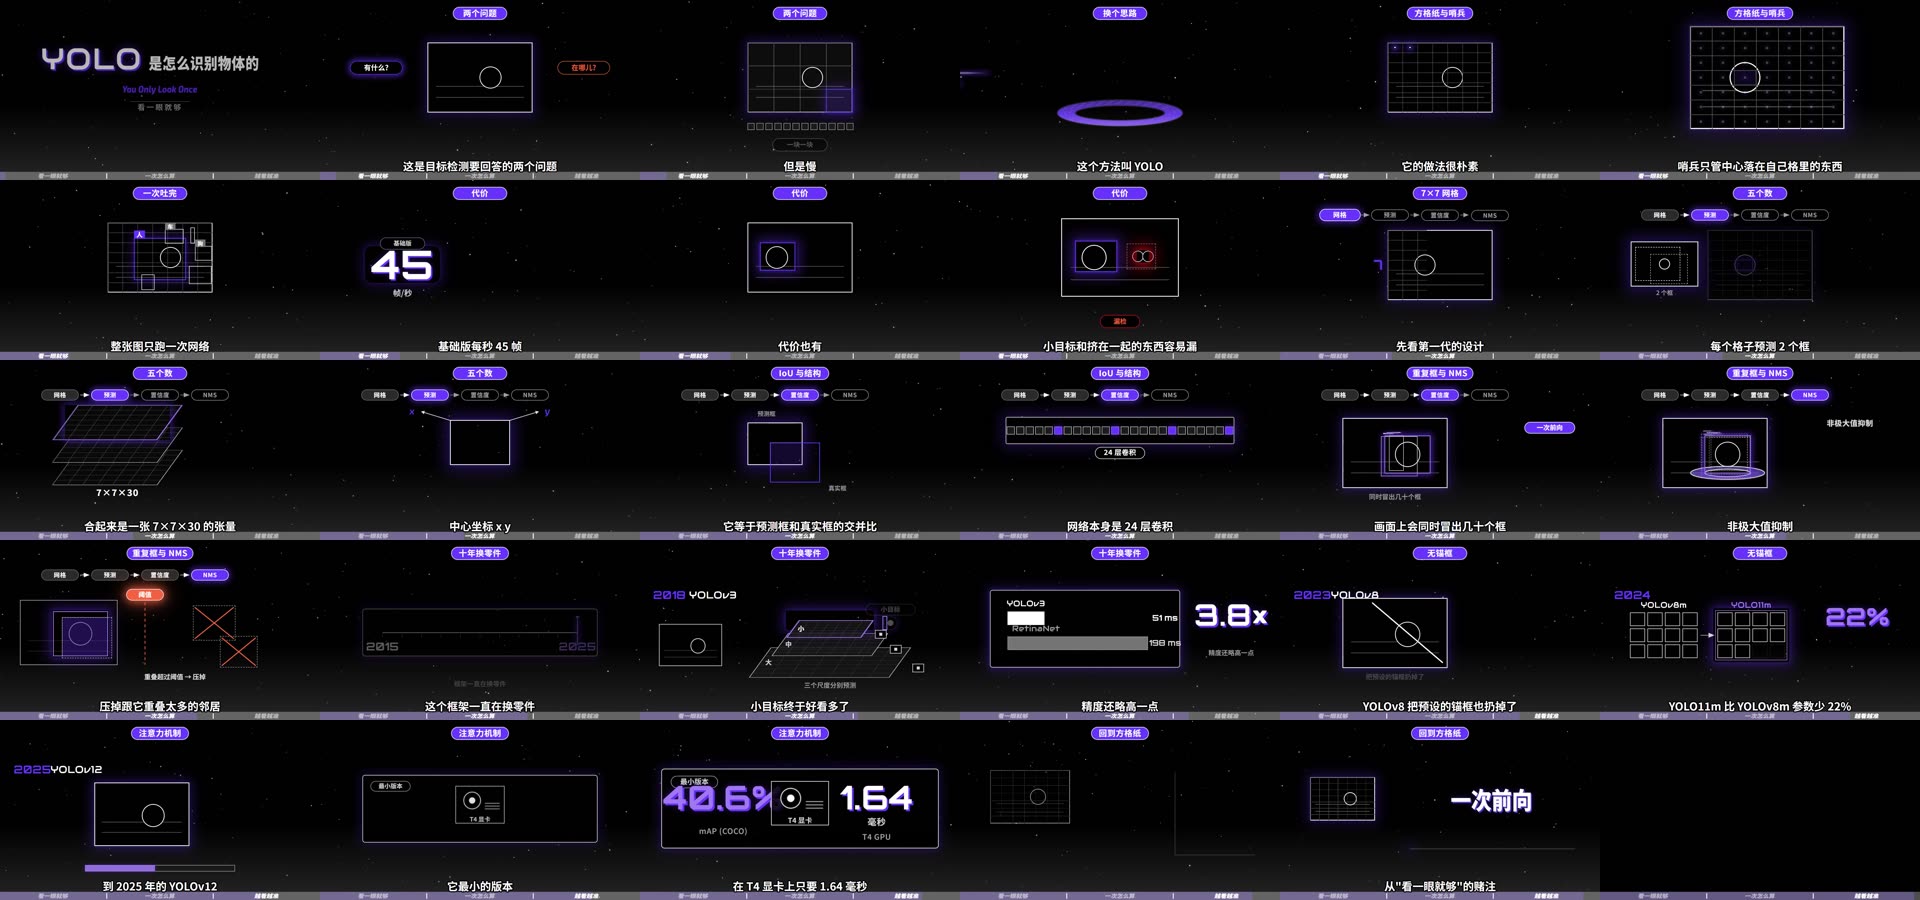
三步验收:逐镜头量指标 → 可疑的镜头单独看全分辨率 → 缩略图总览扫一遍节奏。
有一点必须说明:整个流程里,写画面的过程基本是「盲写」的—— 只能靠量化数字自检,最终观感一定要人看片才能判断。 这也解释了为什么我把「缩略图总览 + 关键帧单看」固定成了必经工序。
成本:¥12,而且可预测
这条片子花了约 ¥12,与开工前的估算吻合——成本是可预测的。 钱主要花在模型 token 上:30 个镜头的源代码是全新生成的, 输出 token 永远不命中缓存,而输出最贵。
至于「复用会不会更便宜」:模型服务商的磁盘缓存是按前缀匹配的, 同一次任务内部反复重发同一段前缀确实能省,但跨任务基本等于从零算。 真正能省钱的杠杆只有三个:控制片长与镜头数、减少返修轮数、 以及别中途重开任务。
这条片子渲了三版才交付。也正是这段经历,让我在后面两条片子里 把「先看拼图找毛病、再决定要不要重渲」变成了固定工序。
这条片子教我的
- 先跑通,再谈优化。 不知道一条片子的完整工序有哪些,就没法判断哪一环值得投入。
- 「不报错」和「结果对」是两件事。 中文字幕乱码、字幕起点错位、主角的光被当成噪声—— 这次最阴的三个问题,没有一个会报错。
- 事实核对要核到句子层面。 数字有出处,不代表这句话有出处。
- 该停手时停手。 把「为什么不修」写清楚,比多渲一版更专业。
说明
画面由代码生成(Remotion + React),配音使用云端 TTS。 全片每一个数字与年份都能在调研底稿里找到带 URL 的出处, 成稿后经过独立的事实核对。