用架构保证一致性,而不是靠提示词祈祷
一条命令跑完「产品抠图 → 空场景生成 → 合成 → 保护区重绘 → 量化质检 → 竖屏成片」。 要解决的是 AIGC 电商素材最核心的那个问题: 模型一生图就会改掉产品本身。
- 我的角色
- 独立完成:架构设计 · ComfyUI 工作流 · Python 编排 · 质检体系 · 工程封装
- 技术栈
- ComfyUI(SDXL)· RMBG-1.4 · Python · ffmpeg · Agent 分镜
- 实测规模
- 6 场景 × 2 seed = 12 张全过 · 单张 130 s · 整批 26 分钟无人值守
- 成本
- ¥0 · 本地 RTX 3060 Laptop 6GB,零 API 费用
一句话摘要
电商要的是「同一颗水晶,换六个场景都还是那颗水晶」。 常见做法是靠提示词描述或 LoRA 去逼近,前者不可证,后者在 6GB 显存下训不出可用的东西。
这套流水线换了一条路:让 diffusion 从头到尾碰不到产品像素—— 用 mask 把产品核心区排除在扩散之外,只重绘背景和产品外圈的光影; 再用一套量化指标把「这批图能不能用」变成可以复跑的数字。
先看结果
同一颗产品,两个场景各出两张。场景在换、随机种子在换,产品没被改。
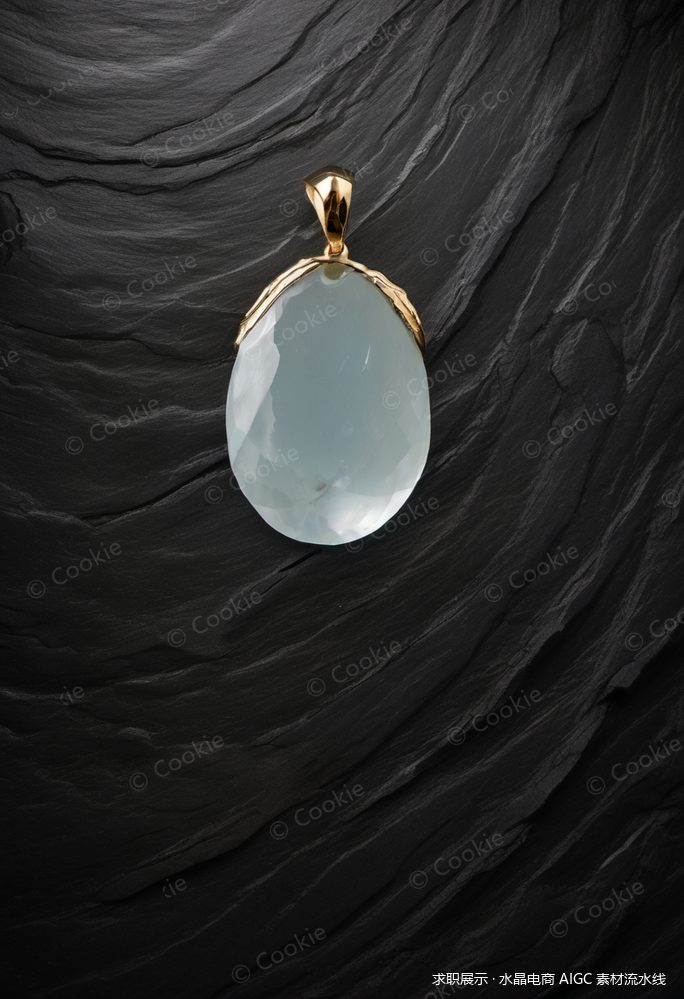
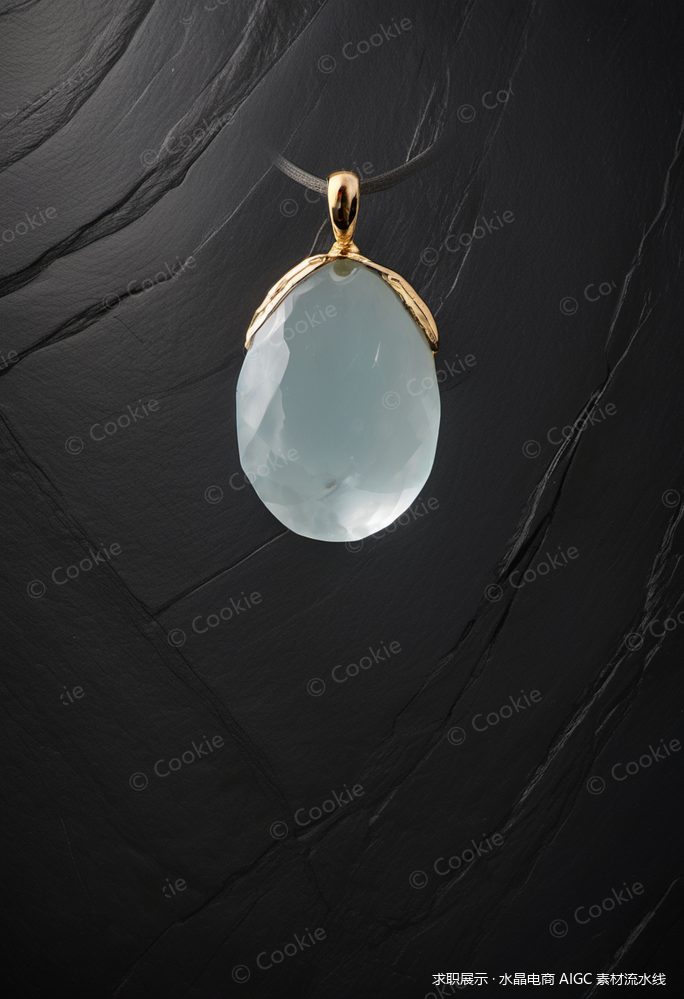
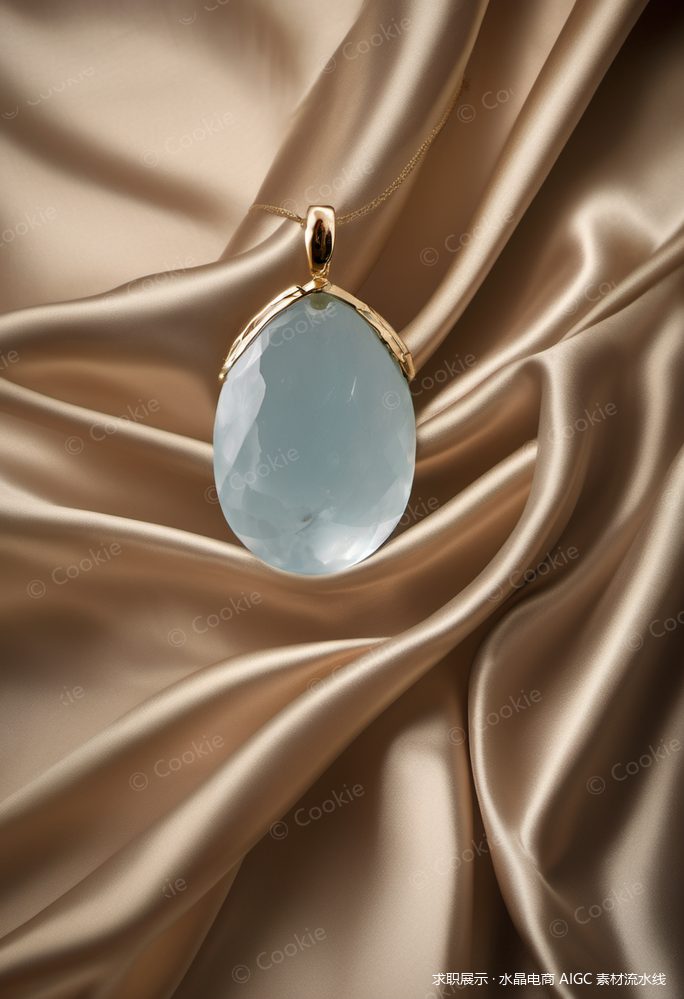
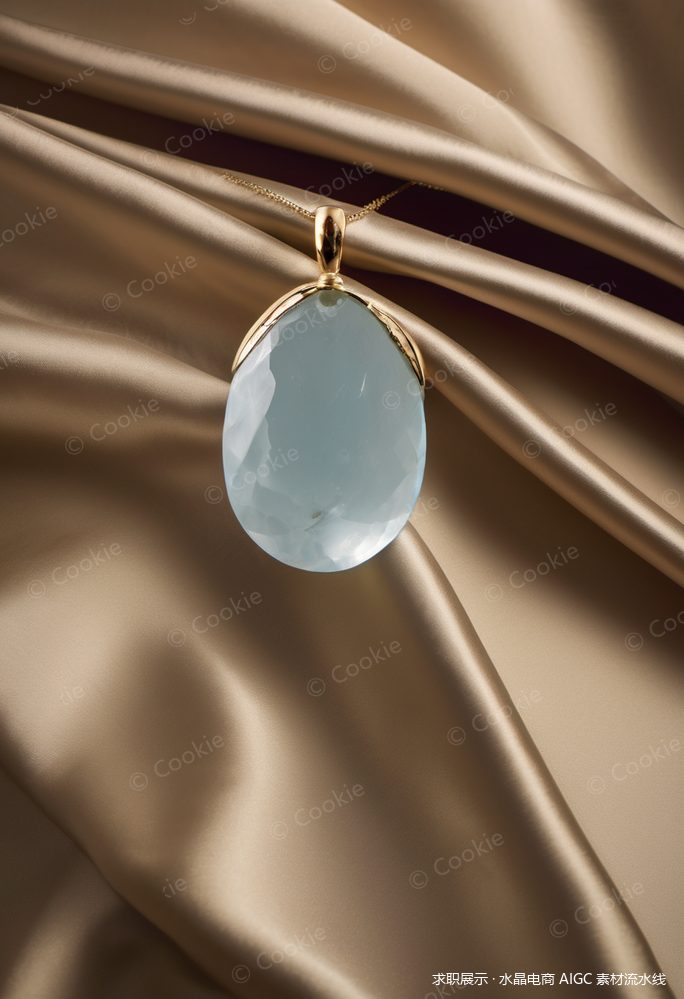
图上标注的是产品核心区的质检读数——只算产品那一块,不是整张图的相似度。 整图相似度会被背景变化拉低,没有参考意义。
核心问题:模型一生图,产品就变了
电商素材的要求很朴素:场景可以换、光影可以换、风格可以换, 但产品本身必须还是那一颗。直接拿产品图去图生图, 模型会顺手把产品重画一遍——形状、切面、颜色全可能漂移。
常见解法有两种:一是堆提示词,二是训 LoRA。前者的问题是不可证—— 你没法证明「这次没改」;后者在我这台 6GB 显存的机器上训不出可用的东西。
解法:让扩散过程碰不到产品像素
| 步骤 | 做什么 | 为什么这么做 |
|---|---|---|
| 1 | RMBG-1.4 抠图(CPU 推理) | 拿到产品 RGBA,不占显存 |
| 2 | 生成不含产品的空场景底图 | 提示词强制「空场景」并用反向提示封掉产品类词——否则模型会自己画一颗水晶,贴上去就变成两颗 |
| 3 | PIL 合成:按场景锚点贴产品 + 拟合接触阴影 | 产出整图与保护区 mask(保护区 = 产品 alpha 腐蚀 min(宽,高)×0.045 像素) |
| 4 | 保护区重绘:VAEEncode → SetLatentNoiseMask → KSampler(denoise 0.45) | 产品核心区被排除,只重绘边缘、阴影和背景——光影真正融进去,产品形态天然保真 |
| 5 | 量化质检:核心区 SSIM / Lab ΔE / 亮度漂移 | 把「能不能用」变成可回归的数字 |
| 6 | 静帧动画化 → 1080×1920 竖屏成片 | 零显存、零成本地补上视频交付 |
三层一致性防线
| 层 | 手段 | 强度 |
|---|---|---|
| 像素级 | 产品核心区 mask 排除,diffusion 没有改写机会 | 最强,可量化验证 |
| 语义级 | 固定主体描述段,场景模板只能改背景段 | 中 |
| 统计级 | 固定 seed 家族,多 seed 出图后按指标挑最优 | 辅助 |
三层里只有第一层是硬的——它不依赖模型「自觉」。 后两层是辅助,用来在没有像素排除的环节兜底。
把「效果好不好」做成可回归的数字
这是我认为这套流水线里最值得讲的一部分。生成结果好不好,绝大多数人靠肉眼看; 但肉眼看不出 0.949 和 0.955 的差别,也没法判断「这一批 12 张里哪张该废」。
| 指标 | 怎么算 | 判据 |
|---|---|---|
| 核心区 SSIM | 分块结构相似度,只算产品区域 | 同批次相对值 + 与背景区对比,不看绝对值(见下) |
| Lab ΔE76 | 色差,取均值与 p95 | 判废线 5.0:人眼约 2.3 可辨,跨图 5 以上会被看出「不是同一颗」 |
| 亮度漂移 | 核心区平均亮度变化 | 超出阈值即判异常 |
实测 6 场景 × 2 seed 共 12 张全部通过: 核心区 SSIM 落在 0.949 – 0.955,均值 0.953、 全距只有 0.0059;ΔE 均值 2.05 – 2.39,均值 2.20。 单张 832×1216 全流程 130 秒,整批 26 分钟无人值守。
为什么 SSIM 是 0.95 而不是 1.0
被保护的像素仍然要过一遍 VAE 的 encode → decode,这是纯损失、与重绘无关。 0.95 就是这套架构的地板。
所以判断异常要看同批次的相对值和 core / bg 双区差异,而不是盯着绝对值。 这一点如果不讲清楚,很容易被理解成「仍有 5% 的偏差」。
关于「12 张 0 废片」——我不会这么说
12 张的样本量撑不起一个能对外讲的废片率。 更准确的说法是:默认参数下跑了 6 个场景 × 2 个 seed 共 12 张,全部通过质检; 更重要的是离散度——全距只有 0.0059,说明一致性是架构保证的,不是碰巧。
要把废片率当对外指标用,seed 至少得提到 8–10 个。
两个静默失效的 bug
这套流水线里有两次失败是「不报错、也不崩溃,只是结果悄悄是错的」。 两次都是靠读源码和自测定位的。
Bug ①:mask 极性被取反了
ComfyUI 的 LoadImage 从 alpha 通道取 mask 时做了 1 - a/255 的取反
(nodes.py:1687)。而 inpaint 的惯例是「白色 = 重绘」——
所以你想保护的产品,反而要被存成不透明。
存反了不会报错,只会让整套一致性策略整体反向生效: 产品被反复重绘,背景反而没动。 修好之后核心区 SSIM 从 0.886 升到 0.950。
Bug ②:77 token 是硬截断,不是分块
SDXL 的 CLIP 文本编码上限是 77 token,超过的部分会被直接丢掉, 而不是自动分块处理。第一版场景模板写了 103 token, 结果排在后面的灯光和相机描述全部被静默丢弃—— 画面看起来「有点不对」,但没有任何报错。
修法是按优先级裁切,并用服务端同款 tokenizer 计数。
这两次之后,我把校验固化成了不依赖 GPU 的 CPU 自测脚本: 一条断言 mask 极性,一条验证质检阈值是否真的有区分度。 跑一次十几秒,比渲一张图再肉眼看便宜得多。
视频这一层:两条路我都试了
机器是 RTX 3060 Laptop,6GB 显存,桌面常驻占掉约 943MB, 实际可用约 5.1GB。Wan、HunyuanVideo 这类本地视频模型在这个显存下要么 OOM, 要么慢到几十秒一帧,产出的还是 512px 的低质量样片。
路线一 · 静帧动画化(本地,零成本)
所以本地这一路没有硬上扩散模型,而是走静帧动画化: 用缩放、位移、光泽扫过和粒子,把成品图变成 1080×1920@30fps 的竖屏短片。 电商短视频里本来就有大量镜头是「产品图 + 推拉 + 光效」,这条路产出的是真能上架的素材, 而且零显存、零成本。
静帧动画化产出的 15 秒竖屏样片(720×1280 网页版)
路线二 · 云端 Seedance 图生视频
除了本地这条路,我也用豆包 Seedance 生成了一条 15 秒的竖屏电商展示视频。 这条走的是产品界面,而不是代码里那套 API 调用层。
豆包 Seedance 生成的 15 秒展示视频(1080×1920 网页版,带音轨)
| 静帧动画化(本地) | Seedance(云端) | |
|---|---|---|
| 成本 | ¥0 | 按次计费 |
| 产物 | 产品图做推拉与光效 | 真·图生视频,画面里有运动 |
| 控制方式 | 代码逐帧确定,可重跑 | 提示词生成,结果需人工挑 |
| 适合 | 批量、零预算、要求产品像素完全不变 | 单条精品,可接受按次付费 |
一个必须说清的差别
上面这条 Seedance 视频是用产品界面生成的, 不是通过流水线里那个 API 层调出来的。
代码里的 video_api.py 依然只写了调用层:参数与字段映射按公开文档整理,
默认 dry_run=True,没有联调过。
这两件事不要混——「我用这个工具做出了东西」和「我把它的 API 接进了工程」是两回事。
已知保留项:哪些问题我故意没修
交付时我把剩下的问题列成了一张表,逐条写明现象和为什么不修。 这只列最值得说的两条:
溪水场景:指标全过,但产品「悬浮」了
forest_water 这个场景三项指标全过,SSIM 还是全场最好之一。
但肉眼看,产品是浮在溪石上方的——接触阴影落不到具体表面上。
已经把这个场景的锚点从画面 62% 高度下调到 80% 重跑对照。 但更根本的问题暴露出来了:现有三项指标只覆盖「产品有没有被改坏」, 不覆盖「产品放得对不对」。「支撑面检测」还没做成自动指标,目前靠三图对照表人眼过。
顺带一条规律:锚点成不成立,取决于底图有没有可落脚的表面。 石板、丝绸、大理石这类全幅纹理没有地平线,产品放哪儿都像躺着; 只有带纵深的场景(溪水、远景)才会把悬浮暴露出来。
12 张的样本量,撑不起一个对外指标
这条已经在上面说过一次,但它是这一批里最重要的「不修」—— 与其把 12 张包装成「废片率 0%」,不如老实说清楚样本量的限制。
工程化:一条命令,断点续跑
整套东西最后封装成了一个可复用的 Skill,配一份环境实录: 6GB 显存的启动参数、国内可用的模型镜像源、ComfyUI 的版本兼容矩阵。
跑批是一句话的事:一条命令无人值守跑完 12 张,中途断了能接着跑。 分镜脚本那一段接的是大模型:按卖点自动产出镜头描述(JSON 严格校验, 没有密钥时自动降级到本地模板)。
这件事对我的意义
表面上看它是个「AIGC 出图工具」,但它练的是三件事,而且都能迁移到 AI 产品上:
- 在约束下选路线。 6GB 显存 + 零预算,决定了不能硬上视频模型; 与其做出一个减分的低质量样片,不如换一条能交付的路。
- 把主观判断变成可复跑的数字。 这和人资智能体的 42 条回归评测集是同一个思路—— 先定义「什么叫做对了」,再谈优化。
- 「不报错」和「结果对」是两件事。 mask 极性、77 token 截断,两个 bug 都不会让程序崩溃, 只会让结果悄悄是错的。这一点在 AI 产品里更常见。
说明
本项目为个人项目,全部在本地完成,零 API 费用。 12 张成品图与质检读数均来自实际运行日志,未做美化; 图生视频接口层默认 dry-run,字段未联调。